지역별 정형외과 비교: 목록 12개의 진료시간 공개율을 셌다 — 13.7%에서 34.0%까지, 과목으로는 안 갈린다
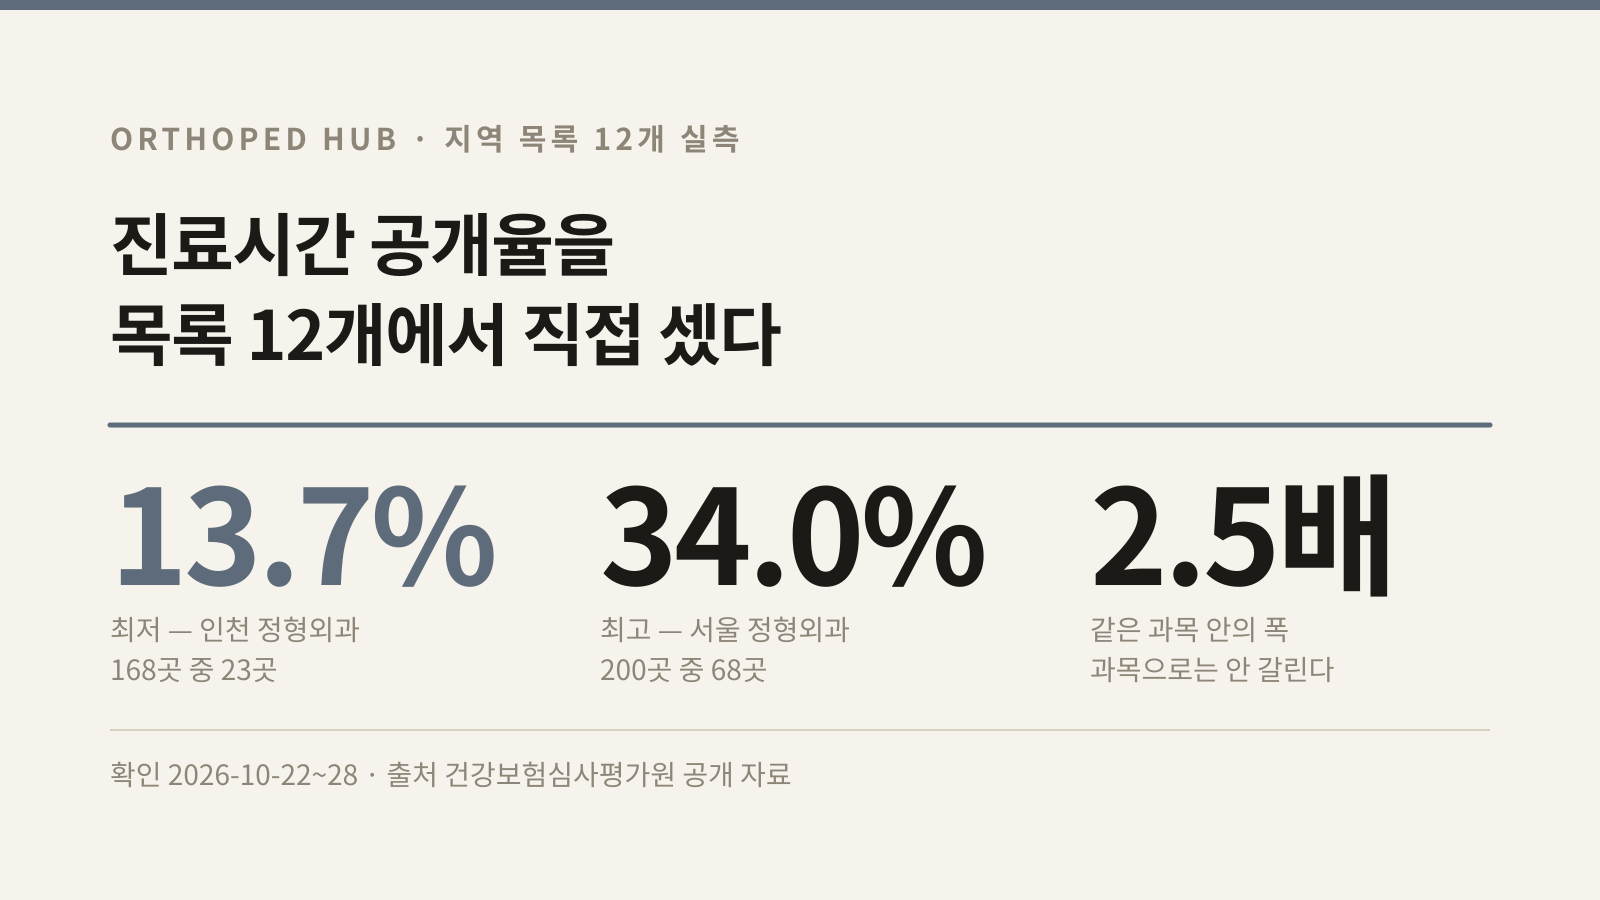
지역별로 정형외과를 비교할 때 가장 먼저 무너지는 것은 기관의 수가 아니라 칸의 채움률이다. 2026-10-22부터 28까지 우리 지역 목록 12개를 열어 직접 세어 봤다.
표에 실린 기관 중 요일별 진료시간이 적힌 비율은 13.7%에서 34.0%까지 벌어졌다. 그리고 이 편차는 과목으로 설명되지 않는다 — 서울에서는 정형외과 쪽이 두 배 넘게 높았고, 인천에서는 한의원 쪽이 더 높았다. 처음 아홉 개를 셌을 때 세웠던 「과목에 따라 갈린다」는 추측은 세 목록을 더 센 뒤 기각했다.
이 글은 그 숫자를 그대로 공개한다. 비교 서비스가 자기 데이터의 빈칸 비율을 적는 경우는 드물지만, 채움률을 모르면 빈칸을 「없음」으로 오독하게 된다. 그 오독이 비교를 망친다.
무엇을 어떻게 셌는가
센 방법은 단순하다. 지역 목록 페이지를 열어, 각 페이지가 스스로 밝힌 문장에서 세 가지 수를 옮겨 적었다.
- 그 지역에 등록된 기관 수와 그 수의 수집 기준일
- 표에 실제로 실린 기관 수 (등록 수와 다를 수 있다)
- 요일별 진료시간이 적힌 기관 수
추정하거나 보간한 값은 없다. 페이지에 문장이 없으면 그 칸은 비워 두었고, 아래 표에 그 상태 그대로 실었다.
행을 하나씩 세지 않고 페이지가 밝힌 문장을 옮긴 데에는 이유가 있다. 사람이 긴 표를 눈으로 세면 목록마다 오차가 다르게 들어가고, 그러면 목록 간 차이가 실제 차이인지 내 실수인지 구분되지 않는다. 같은 자리에서 생성된 같은 형식의 문장을 옮기면 열두 줄에 같은 기준이 적용된다. 집계에서 중요한 것은 정확도보다 기준의 일관성일 때가 많다.
고른 12개는 규모와 과목이 서로 다르도록 뽑았다. 전국 대표 표본이 아니라 편차가 얼마나 벌어지는지 보기 위한 표본이다.
1차 집계 — 9개 목록 (2026-10-22~23 확인)
| 목록 | 수집 기준일 | 등록 기관 | 표에 실린 곳 | 진료시간이 적힌 곳 | 공개율 |
|---|---|---|---|---|---|
| 서울 정형외과 | 2026-09-03 | 740곳 | 200곳 | 59곳 | 29.5% |
| 부천 정형외과 | 2026-08-15 | 56곳 | 55곳 | 15곳 | 27.3% |
| 대전 정형외과 | 2026-09-03 | 81곳 | 80곳 | 20곳 | 25.0% |
| 수원 정형외과 | 2026-09-03 | 70곳 | 70곳 | 8곳 | — |
| 대구 정형외과 | 2026-08-15 | 169곳 | 169곳 | (문장 없음) | — |
| 인천 한의원 | 2026-09-03 | 702곳 | 200곳 | 34곳 | 17.0% |
| 대구 한의원 | 2026-09-03 | 918곳 | 200곳 | 13곳 | 6.5% |
| 대전 한의원 | 2026-09-03 | 514곳 | 200곳 | 6곳 | — |
| 부산 한의원 | 2026-09-03 | 1,112곳 | 200곳 | 4곳 | — |
공개율 칸의 줄표 네 개는 이유가 두 가지로 갈린다. 수원 정형외과·대전 한의원·부산 한의원은 분자가 한 자리(8곳·6곳·4곳)여서 비율로 적지 않았다. 한 곳만 늘어도 비율이 크게 흔들리는 구간이라, 퍼센트로 쓰면 실제보다 단단해 보인다. 대구 정형외과는 사정이 다르다. 그 수를 밝히는 문장이 페이지에 아예 없다. 모르는 것과 작은 것은 다르게 표시해야 해서 같은 줄표를 쓰되 이유를 따로 적는다.
며칠 뒤 다시 세어 보니 (2026-10-26 · 28)
같은 문장을 2026-10-26과 28에 다시 읽었다. 목록을 골라 두 번째·세 번째로 센 결과다.
| 목록 | 10-22~23 | 10-26 | 10-28 | 변화 |
|---|---|---|---|---|
| 서울 정형외과 | 200곳 중 59곳 | 200곳 중 68곳 | 200곳 중 68곳 | +9곳 뒤 멈춤 |
| 부천 정형외과 | 55곳 중 15곳 | — | 55곳 중 15곳 | 없음 |
| 수원 정형외과 | 70곳 중 8곳 | 70곳 중 8곳 | — | 없음 |
| 부산 한의원 | 200곳 중 4곳 | 200곳 중 4곳 | — | 없음 |
| 대구 정형외과 | 문장 없음 | 문장 없음 | — | 없음 |
여기서 세 가지가 읽힌다.
첫째, 분모는 가만히 있는데 분자가 움직인다. 서울 정형외과의 수집 기준일은 세 번 모두 2026-09-03이고 등록 740곳·표 200곳도 그대로다. 바뀐 것은 시간이 적힌 칸의 수뿐이다. 즉 기관 명단을 다시 수집하는 일과 운영 시각을 채우는 일이 따로 돈다. 목록 머리글의 기준일만 보고 「며칠 전과 같겠지」라고 넘기면 안 되는 이유가 이것이다.
둘째, 그 +9는 추세가 아니었다. 2026-10-28에 같은 문장을 또 읽었더니 68곳 그대로였다. 세 시점(59 → 68 → 68)이 모이고 나서야 말할 수 있는 것은 이렇다 — 한 번 늘고 멈췄다. 두 번째 회차만 보고 「공개율이 오르는 중」이라고 적었다면 틀린 문장이 됐을 것이다.
셋째, 움직이는 속도가 목록마다 다르다. 다시 센 목록 중 움직인 것은 서울 하나다. 부천은 2026-10-22과 28 두 번 모두 15곳이었고, 기준일도 2026-08-15에서 바뀌지 않았다.
재집계 값을 1차 표에 덮어쓰지 않고 따로 둔 이유도 같다. 두 날짜의 값을 한 표에 섞으면 어느 줄이 언제 값인지 알 수 없게 되고, 그 순간 비교가 성립하지 않는다.
세 목록을 더 셌다 (2026-10-28 확인)
아홉 줄만으로는 과목별 경향을 말할 수 없다고 판단해, 같은 도시에서 두 과목을 맞춰 볼 수 있도록 세 목록을 추가로 셌다.
| 목록 | 수집 기준일 | 등록 기관 | 표에 실린 곳 | 진료시간이 적힌 곳 | 공개율 |
|---|---|---|---|---|---|
| 서울 한의원 | 2026-09-03 | 3,733곳 | 200곳 | 30곳 | 15.0% |
| 부산 정형외과 | 2026-09-03 | 192곳 | 192곳 | 29곳 | 15.1% |
| 인천 정형외과 | 2026-09-03 | 168곳 | 168곳 | 23곳 | 13.7% |
서울 한의원의 등록 3,733곳은 열두 목록 중 가장 큰 모집단이다. 반대로 부산·인천 정형외과는 등록 수가 200곳을 넘지 않아 전량이 표에 들어간다.
「과목에 따라 공개율이 다르다」를 기각한다
이 세 줄을 넣고 나서 같은 도시의 두 과목을 맞춰 볼 수 있게 됐다. 분자가 두 자리 이상이어서 비율로 말할 수 있는 쌍은 둘이다.
| 도시 | 정형외과 | 한의원 | 어느 쪽이 높나 |
|---|---|---|---|
| 서울 | 68/200 = 34.0% | 30/200 = 15.0% | 정형외과 |
| 인천 | 23/168 = 13.7% | 34/200 = 17.0% | 한의원 |
두 쌍의 방향이 반대다. 한 쌍만 봤다면 과목 차이로 읽었을 값이고, 두 쌍을 보니 그 설명이 안 남는다.
남은 세 도시는 판정에 쓰지 않았다. 대전(정형외과 25.0% · 한의원 6곳)과 부산(정형외과 15.1% · 한의원 4곳)은 한의원 쪽 분자가 한 자리라 비율로 비교할 수 없고, 대구는 정형외과 쪽에 채움률 문장이 없다. 쓸 수 없는 줄을 끌어오면 원하는 결론이 나오는데, 그게 바로 하지 말아야 할 일이다.
더 분명한 근거는 한 과목 안의 폭이다. 정형외과 목록만 모아 보면 인천 13.7%에서 서울 34.0%까지 2.5배 차이가 난다. 서울에서 두 과목이 벌어진 간격보다 넓다. 그렇다면 편차를 만드는 변수는 과목이 아닌 다른 것이고, 우리는 그것이 무엇인지 아직 모른다. 모르는 채로 멈추는 것이 추측으로 메우는 것보다 낫다.
실무적으로 남는 지침은 하나다. 과목 이름으로 공개율을 짐작하지 말고, 볼 목록을 열어 그 페이지의 문장을 직접 읽어라.
200곳 상한은 어느 목록에 걸리나
열두 줄을 모아 보니 절단이 걸리는 쪽이 분명해졌다.
- 정형외과 목록 7개 중 상한이 걸린 것은 서울 하나뿐이다. 부산 192곳·대구 169곳·인천 168곳·대전 81곳·수원 70곳·부천 56곳은 전부 200곳 아래라 전량이 실린다.
- 한의원 목록 5개는 전부 걸린다. 서울 3,733곳·부산 1,112곳·대구 918곳·인천 702곳·대전 514곳 모두 200곳에서 잘린다.
같은 상한을 쓰는데 한쪽에서만 작동하는 셈이다. 그래서 「상위 200곳」이라는 표현이 뜻하는 바가 목록마다 다르다. 정형외과 쪽에서는 대개 전수에 가깝고, 한의원 쪽에서는 일부 발췌다.
분자도 분모도 없는 지역이 따로 있다
위 열두 줄은 두 수가 모두 적혀 있던 목록이다. 열두 줄을 그렇게 고른 것이고, 그 선택이 무엇을 가렸는지도 적어 둔다.
2026-10-27에 아직 세지 않은 지역을 세 곳 더 열어 봤다. 결과는 세 가지로 갈렸다.
| 2026-10-27에 열어 본 주소 | 돌아온 화면 |
|---|---|
| 광주 정형외과 | 표 없음 — 「수록 기관 0곳」과 수집 중 안내 |
| 광주 한의원 | 표 없음 — 같은 상태 |
| 울산 정형외과 | 없는 페이지(404) |
같은 사이트 안에서 세 가지 상태가 동시에 존재한다. 수가 적힌 목록, 주소는 열리지만 표가 없는 목록, 주소 자체가 없는 경우다. 열두 줄짜리 집계는 첫 번째 상태에서만 뽑은 것이다.
왜 광주가 비어 있는지는 그 페이지가 밝히지 않는다. 우리 수집 규칙에는 비교에 쓸 수 있는 기관이 열다섯 곳에 못 미치면 표를 내보내지 않는다는 조항이 있지만, 광주가 그 조항에 걸린 경우인지는 페이지에 적혀 있지 않아 확인할 수 없다. 모르는 것을 아는 것처럼 적지 않는다.
머리글 날짜에서 한 가지가 더 드러났다. 수가 적힌 목록의 머리글에는 수집한 날짜(2026-09-03·2026-08-15)가 적혀 있는데, 광주 두 페이지의 머리글에 적힌 날짜는 내가 그 페이지를 연 날인 2026-10-27이었다. 화면만 보고는 그 날짜가 수집일인지 조회일인지 가릴 수 없다. 따라서 머리글 날짜가 오늘이라는 사실은 그 목록이 오늘 채워졌다는 증거가 못 된다. 날짜는 수와 함께 읽어야 하고, 수가 0이면 날짜는 아무것도 보증하지 않는다.
0곳을 「광주에 정형외과가 없다」로 읽으면 안 된다. 그 화면이 말하는 것은 우리 쪽 상태 하나다. 지역 수 147개도 같은 방식으로 읽는 편이 정확하다 — 표가 선 지역과 아직 서지 않은 지역을 함께 센 값이다.
이 표를 읽을 때 틀리기 쉬운 세 가지
분모가 줄마다 다르다
「등록 기관」과 「표에 실린 곳」이 같은 줄도 있고 다른 줄도 있다. 표에 실리는 상한은 200곳이고, 등록 수가 그보다 적으면 전부 실린다. 그래서 수원(70곳)과 인천 정형외과(168곳)는 전량이 표로 들어가고, 한의원 다섯 줄은 전부 200곳에서 잘린다.
한 곳씩 빠진 줄도 둘 있다. 대전 정형외과는 81곳 중 80곳, 부천 정형외과는 56곳 중 55곳이다. 비교에 필요한 값을 갖추지 못한 기관이 각각 하나씩 빠진 결과다.
그래서 공개율의 분모는 표에 실린 곳으로 통일했다. 등록 수를 분모로 쓰면 큰 지역의 공개율이 실제보다 훨씬 낮게 보인다. 분모를 밝히지 않은 비율은 숫자가 아니라 인상이다.
기준일이 목록마다 다르다
둘째 열을 보면 열 줄은 2026-09-03이고 두 줄(대구 정형외과·부천 정형외과)만 2026-08-15다. 같은 사이트 안에서 19일 차이가 난다.
날짜가 두 개로만 갈린다는 점이 중요하다. 지역마다 제각각 돌아가는 것이 아니라 묶음 단위로 수집이 돌고, 어떤 묶음은 다음 차례가 아직 오지 않았다는 뜻이다. 모든 목록에 「오늘 기준」이라고 적어 두면 보기에는 깔끔하지만, 8월에 수집한 값이 10월의 값으로 둔갑한다. 날짜를 줄마다 따로 적으면 독자가 어느 줄을 더 믿을지 스스로 정할 수 있다.
빈칸은 0이 아니다
가장 자주 일어나는 오독이 이것이다. 진료시간 칸이 비어 있는 기관을 「그 시간에 문을 닫는 곳」으로 읽는 것. 비어 있다는 것은 그 값이 아직 확인되지 않았다는 뜻이고, 그 기관이 토요일에 여는지 아닌지는 이 표가 답하지 않는다.
부산 한의원을 예로 들면, 표에 실린 200곳 중 4곳에만 시간이 적혀 있다. 나머지 196곳을 후보에서 지우면 선택지를 거의 다 근거 없이 버리는 셈이 된다. 올바른 처리는 따로 모아 두는 것이다. 시간이 적힌 4곳으로 먼저 추리고, 조건에 맞는 곳이 부족하면 나머지에 전화를 건다.
왜 목록마다 이렇게 갈리는가
첫째, 운영 시각은 기관이 스스로 알려야 생기는 값이다. 기관의 존재·소재지·표시 과목은 등록 절차에서 자동으로 남지만, 요일별 시각은 그 기관이 따로 적어 둔 경우에만 공개 자료에 실린다. 그래서 등록은 전부 잡히고 시간은 일부만 잡힌다. 구조적으로 채움률이 낮을 수밖에 없는 항목이다. 서울에서 아홉 칸이 늘어난 것도 이 구조에서 나온다 — 누군가 값을 적어 넣으면 그만큼만 채워진다.
둘째, 모집단이 크면 상위만 보게 된다. 표에 보이는 비율을 계산하면 서울 한의원이 3,733곳 중 200곳으로 5.4%, 부산 한의원이 1,112곳 중 18.0%, 대구가 918곳 중 21.8%, 인천이 702곳 중 28.5%, 대전이 514곳 중 38.9%다. 같은 「상위 200곳」이라는 표현을 써도 보이는 비율이 5.4%에서 38.9%까지, 일곱 배 넘게 벌어진다. 잘려 나간 기관 수로 따지면 서울 한의원이 3,533곳, 부산이 912곳이다.
이 절단이 무엇을 가리는지도 짚어 둘 필요가 있다. 상위 200곳은 의사 수를 기준으로 추려진 묶음이다. 규모가 큰 기관이 위로 올라오므로, 표만 보면 그 지역이 실제보다 크고 체계적인 곳들로 채워진 듯 보인다. 동네의 작은 의원은 잘려 나간 쪽에 남아 있다. 가까운 곳을 찾는 사람에게는 오히려 그쪽이 필요한 경우가 많다. 절단된 목록은 틀린 목록이 아니라 특정 방향으로 기운 목록이고, 기울기를 알고 보는 것과 모르고 보는 것은 다르다.
공개율을 적어 두면 무엇이 달라지나
채움률을 숨기는 쪽이 보기에는 낫다. 표가 듬성듬성한 것보다 꽉 찬 것이 완성돼 보이고, 비어 있는 칸은 미완성처럼 읽히기 때문이다. 그런데 숨기면 두 가지가 동시에 망가진다.
사용자 쪽에서는 전략이 바뀌지 않는다. 공개율이 34.0%인 목록과 200곳 중 4곳인 목록에서 「토요일 오전」을 거는 일은 전혀 다른 작업인데, 숫자를 모르면 같은 작업으로 느껴진다. 후보가 적게 남았을 때 그것이 기관이 없어서인지 값이 없어서인지 판단할 근거가 없고, 그러면 대개 목록을 탓하고 떠난다. 실제로 필요한 행동은 남은 기관에 전화를 거는 것이었는데도 그렇다.
운영 쪽에서는 유혹이 생긴다. 채움률이 드러나지 않으면 빈칸을 그럴듯한 값으로 메우는 쪽이 언제나 더 쉬운 선택지가 된다. 반대로 공개율을 지표로 내걸면 올릴 방법이 하나로 좁혀진다 — 실제로 확인된 값을 늘리는 것뿐이다. 지표를 공개하는 일이 곧 스스로 손발을 묶는 장치다. 서울의 +9칸은 그 방향으로 움직인 기록이기도 하다.
이 숫자로 할 수 있는 일과 할 수 없는 일
할 수 있는 일 — 내가 보고 있는 목록을 얼마나 신뢰할지 조정하는 것이다. 공개율이 높은 목록에서 「토요일 오전」 조건을 걸면 후보가 꽤 남지만, 200곳 중 4곳짜리 목록에서 같은 조건을 걸면 거의 남지 않는다. 후보가 적게 남는 이유가 기관이 없어서가 아니라 값이 없어서라는 것을 알면 다음 행동이 달라진다.
할 수 없는 일 — 이 표로 지역의 의료 접근성을 비교할 수는 없다. 공개율은 그 지역 기관들이 정보를 얼마나 적어 두었는지를 재는 값이지, 진료를 얼마나 잘하는지나 얼마나 늦게까지 여는지를 재는 값이 아니다. 데이터 품질 지표를 서비스 품질 지표로 읽으면 완전히 틀린 결론이 나온다.
과목 사이의 우열도 여기서 읽을 수 없다. 앞에서 본 대로 같은 도시에서 방향이 뒤집히기 때문이다.
금액도 이 표에 없다. 우리는 기관별 비급여 금액을 수록하지 않으므로, 지역별 가격 비교는 이 자료로 할 수 없다.
다른 지역 목록을 직접 확인하는 법
같은 방식으로 아무 지역이나 확인할 수 있다. 페이지에 적힌 문장을 그대로 읽으면 된다.
목록 머리글에 「{기준일} 기준, {지역} {과목} {N}곳 지역 비교입니다」가 있고, 표 근처에 「진료시간은 요일별로 확인된 {N}곳에만 적었습니다」가 있다. 두 문장을 찾으면 그 목록의 분모와 분자가 모두 나온다. 두 번째 문장이 보이지 않으면, 그 목록은 이 글의 대구 정형외과 줄처럼 채움률을 알 수 없는 상태다. 머리글의 수가 0곳이면 그 지역은 아직 집계 전이다.
한 번 더 권하자면, 며칠 뒤에 같은 문장을 다시 읽어 보는 것도 해 볼 만하다. 서울에서 확인했듯 기준일이 그대로여도 분자는 바뀔 수 있다. 다만 한 번 바뀌었다고 계속 바뀌는 것도 아니다.
실제 목록은 서울 정형외과 지역 페이지에서 모양을 확인할 수 있고, 무엇을 모으고 무엇을 버리는지는 수집 방법 페이지에 적혀 있다. 같은 자로 재는 대상은 147개 지역에 걸친 17,801곳이다. 한 지역에서 비교에 쓸 수 있는 기관이 열다섯 곳에 못 미치면 표를 만들지 않는데, 이때 주소가 사라지는 것은 아니고 표가 있던 자리에 수집 중이라는 안내가 들어간다. 네 곳짜리 목록은 비교가 아니라 나열이기 때문이다.
처치 단위에서 무엇을 물어야 하는지는 도수치료와 물리치료 차이, 진료 전에 확인할 5가지에 정리해 두었다.
이 집계의 한계
다섯 가지를 분명히 해 둔다.
첫째, 표본이 12개이고 재집계는 서울 3회·그 밖 4개 2회다. 147개 지역 중 열두 줄을 뽑았고, 규모와 과목이 서로 다르도록 고른 것이지 무작위로 고른 것이 아니다. 따라서 위 범위는 「이만큼 벌어질 수 있다」는 뜻이지 전체 평균이 아니다.
둘째, 같은 도시 두 과목 쌍은 두 개뿐이다. 서울과 인천이고, 둘의 방향이 반대라 과목 가설을 기각했다. 다만 쌍 두 개로 기각한 것이므로 「과목이 전혀 무관하다」는 증명도 아니다. 지금 말할 수 있는 것은 「과목으로 예측할 근거가 없다」까지다. 쌍이 더 모이면 다시 센다.
셋째, 「진료시간이 적혔다」가 「지금도 그 시간에 연다」를 뜻하지 않는다. 운영 시각은 기관 사정으로 바뀐다. 방문 직전에 한 번 더 확인하는 절차는 어떤 경우에도 생략할 수 없다.
넷째, 열두 줄은 수가 적혀 있던 목록 중에서 뽑았다. 2026-10-27에 확인한 광주 두 목록처럼 표가 아직 없는 지역은 애초에 셀 수가 없었고, 울산 정형외과 주소는 404였다. 그러니 위 공개율 범위는 표가 선 목록들의 범위이고, 147개 지역 전체의 상태를 대표하지 않는다. 비어 있는 지역이 몇 곳인지도 우리는 이 글에서 세지 않았다.
다섯째, 이 글은 치료나 진료과 선택에 대해 아무 말도 하지 않는다. 어디가 적합한지는 진찰로만 정해진다. 여기서 다룬 것은 목록을 얼마나 믿고 읽을 것인가뿐이다.
값이 확인되지 않은 칸은 채우지 않는다. 비어 있는 칸도 정보다.